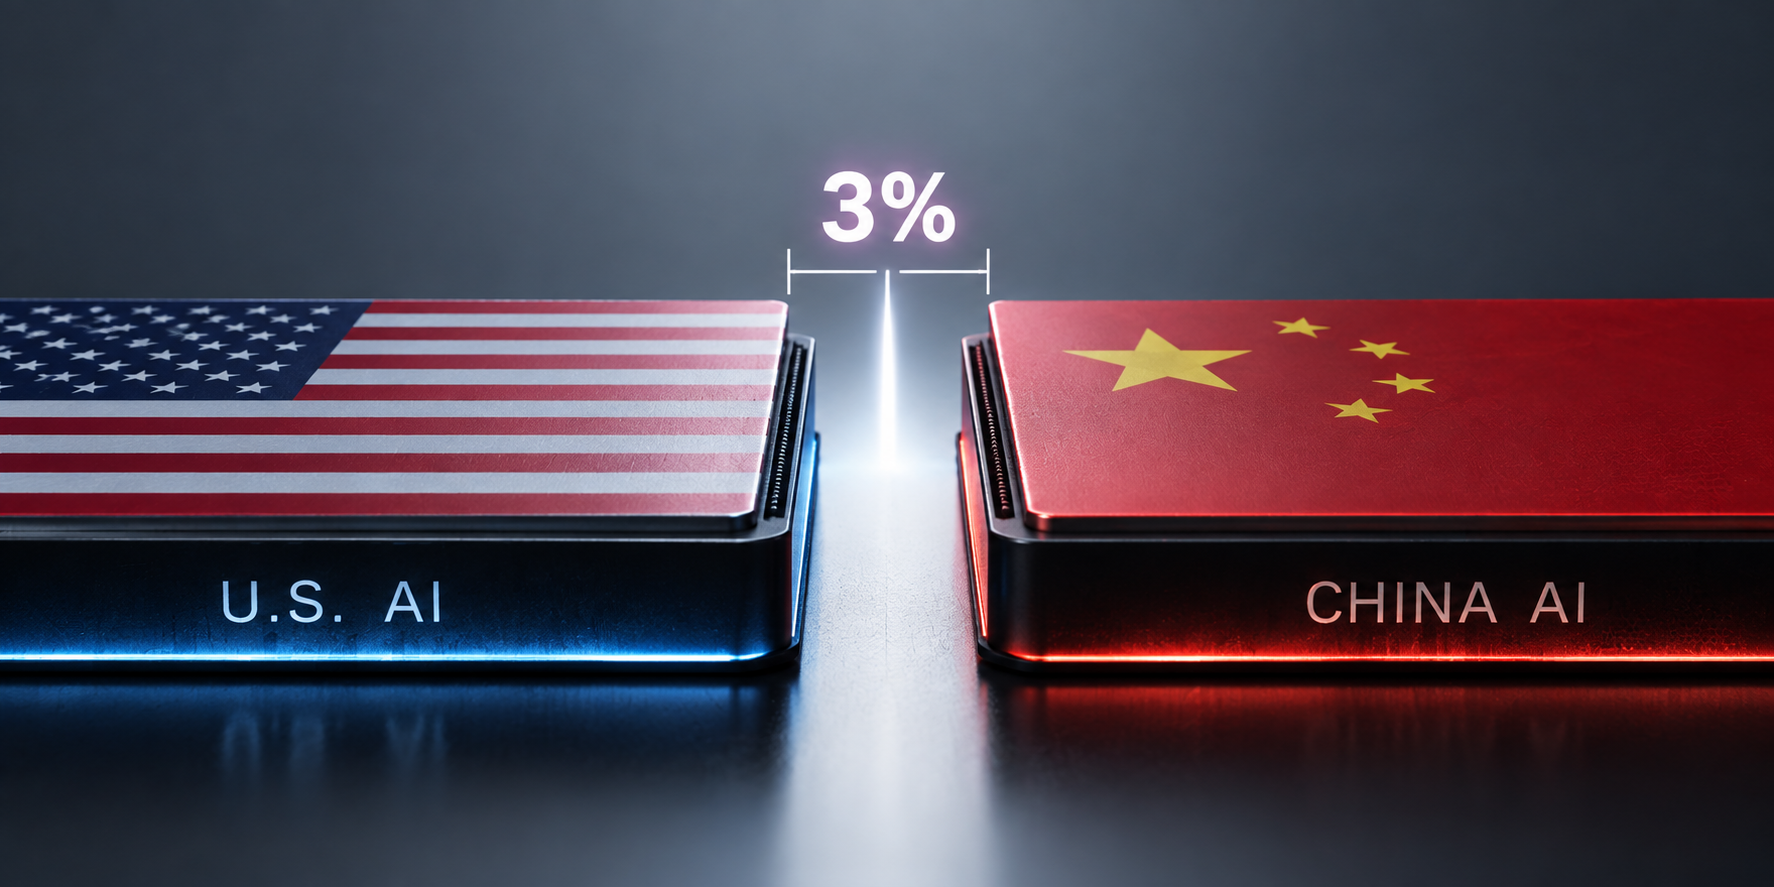
中美頂尖 AI 模型的跑分差距,在 DeepSeek 9 月推出 V4.1 Flash 後縮到 3%,創下歷史新低。彭博行業研究指出,中國業者雖然在榜單上追得很近,但整個產業可能要到 2030 年才賺得到錢。
(前情提要:DeepSeek V4.1 Flash 將上線,官方自評超車 Pro、帳單砍三分之二)
(背景補充:Mozilla 報告:中國開源 AI 只落後美國 4 個月,但價格只要 30~60%)
中美頂尖 AI 模型的跑分差距,已經縮到 3%。但價格卻是另一個故事:換算下來,每輸出百萬個 token,Anthropic 旗艦模型的報價是 DeepSeek 的 42 到 83 倍。
彭博行業研究資深分析師 Robert Lea 在最新報告中寫道,DeepSeek 9 月推出 V4.1 Flash 之後,中美頂尖模型的跑分差距創下歷史新低。
3% 是怎麼量出來的
Lea 給出的數字是:中國頂尖模型在跑分上落後美國對手 3%,5 月時約為 9%,今年稍早則是 15% 左右。他認為,表現持續改善,代表中國業者還會拿下更多市佔率。
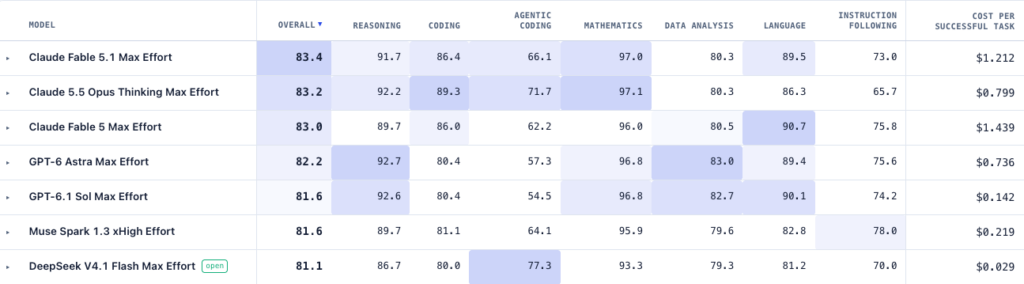
這個分數來自 LiveBench,一份公開榜單,拿題目、謎題和任務考模型,再按回答給分,做法類似測人類的智商。彭博寫道,V4.1 Flash 在 9 月的全球排名第六,是 DeepSeek 自 2025 年憑推理模型 R1 開創局面以來,排名最高的中國模型。DeepSeek 最近一次的總分是 81.1,Anthropic 的最佳成績為 83.4,Lea 因此認為,這款模型與 Anthropic、OpenAI 的頂尖模型已經「表現相當」。
目前查閱榜單原始資料,榜首是 Anthropic 的 Claude Fable 5.1,與 V4.1 Flash 相差 2.3 分,約 2.8%,四捨五入就是彭博所說的 3%。
分項更有看頭。榜單裡的 Agentic Coding,就是讓模型自己動手改程式、跑測試、把任務做完,DeepSeek V4.1 Flash 在這項拿到 77.3 分,是全榜最高分,Claude Fable 5.1 則是 66.1 分。但落後的分項也很清楚:推理 86.7 對 91.7,語言 81.2 對 89.5。
便宜幾十倍的對手
為什麼追得上?彭博在報導中歸納出兩個原因:中國的 AI 專業能力持續加深,研究人員也有本事針對國產硬體最佳化模型。
彭博寫道,這些進展讓人質疑美國出口限制的效用。華府限制輝達晶片等技術輸出,原本是要延緩中國的 AI 進展,並阻止華為等業者做出替代品。Lea 直言,中國的進展「進一步讓人懷疑美國在 AI 領域的技術霸權能否長期維持」。
時機也敏感。彭博指出,Anthropic 與 OpenAI 正以兆美元等級的估值籌備上市,主打的正是能力領先;中國的低價模型,在用戶數上也逐步拉近與美國對手的距離。
依 DeepSeek 官方定價頁,V4.1 Flash 每百萬 token 的輸出價為 0.60 美元(離峰時段)或 1.20 美元(尖峰時段)。對照 Anthropic 官方定價頁,Claude Fable 5.1 每百萬 token 輸出要價 50 美元。換算下來,價差約 42 倍(對尖峰價)到 83 倍(對離峰價)。
當然,這個倍數有但書:單價不等於把一件工作做完的總成本,不同模型完成同一任務耗用的 token 數並不相同。即便如此,分數接近、單價差幾十倍,仍難以忽視。
分數追上了,錢還沒賺到
不過彭博指出,儘管分差縮到 3%,中國模型要變現都不容易。
Lea 預估,中國 AI 產業可能要到 2030 年才會賺錢。原因是業者集中在低毛利的 token 供應,加上慘烈的價格戰,在擠了 1,100 多個大型語言模型的國內市場裡,可能沒有一家能建立競爭優勢。
他點名字節跳動的豆包是 AI 應用變現的領先者,DeepSeek 與騰訊的聊天機器人至今仍免費。他的處方是:「要讓中國 AI 產業站上可持續的獲利基礎,需要競爭壓力降溫、產業洗牌,以及更理性的定價。」
3% 這個數字會隨榜單更新而變動。比較難變的,是 1,100 多個模型擠在同一個市場的現實。
📍相關報導📍
DeepSeek 開源華為昇騰六大元件:TileLang 直接「對標 CUDA」欲替代輝達
OpenRouter:中美 AI 差距只有 3~6 個月,開源模型正席捲世界