


Sonnet 5.5 價格只有 Opus 5.5 的一半,卻在多項代理式程式評測追平旗艦。第三方測出它在最高推理強度下最耗 token,官方則說多數工作更省,差別在推理強度選哪一檔。
(前情提要:Anthropic 突襲發布 Claude Opus 5.5!效能逼近 Fable,API 降價 40% 還自帶「用量重置」)
(背景補充:Claude Sonnet 5 上線:Anthropic 喊多項表現逼近 Opus,但 API 費用便宜 6 成)
Anthropic 於今晨發布 Claude Sonnet 5.5,在 Terminal-Bench 4.0 拿下 70.6%,高於 Opus 5.5 的 66.4%,而它的價格剛好是 Opus 5.5 的一半。不過,第三方評測機構卻替它貼上另一張標籤:史上最耗 token 的模型。
官方說便宜,第三方說更貴,兩邊的數字都是真的,為什麼會這樣?
半價旗艦的成績單
Sonnet 5.5 是 Claude 5.5 家族的第二款模型,旗艦 Opus 5.5 在不到一週前才剛發布。根據官方公告,Sonnet 5.5 最擅長範圍明確的日常任務、修 bug,以及產出精緻的報告、簡報與試算表,對設計也有不錯的眼光;需要審慎判斷的複雜工作,仍歸 Opus 5.5。
Claude 全產品線即日上線,API 另在 AWS、Google Cloud 與 Microsoft Azure 提供,並可選擇零資料保留。
價格是每百萬 token 輸入 2 美元、輸出 10 美元,快取讀取 0.2 美元、快取寫入 2.5 美元;Opus 5.5 則是輸入 4 美元、輸出 20 美元,Sonnet 5.5 剛好一半。
跑分上,它相對 Sonnet 5 是跳躍式進步:Terminal-Bench 4.0 從 10.3% 升到 70.6%。對上 Opus 5.5,它在操作電腦的 OSWorld 2.1(80.1% 對 81.8%)與 CursorBench 4.0(55.5% 對 57.8%)都只差一點點,在知識工作的 GDPval-AA 更以 Elo 1844 對 1846 幾乎持平。同一項評測裡,OpenAI 的 GPT-6 Sol 只有 1487。圖表理解的 Chartography,Sonnet 5.5 是 61.6%,Opus 5.5 是 64.4%,GPT-6 Sol 為 53.6%,Sonnet 5 僅 15.6%。
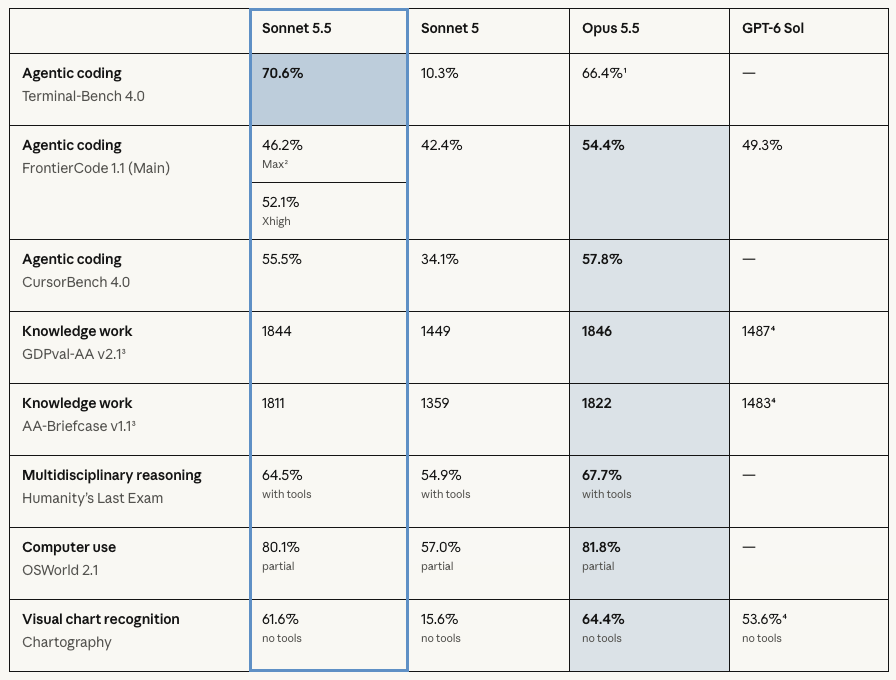
但差距仍在。Humanity’s Last Exam 是 64.5% 對 67.7%,FrontierCode 1.1 是 46.2% 對 54.4%,Sonnet 5 則分別停在 54.9% 與 42.4%。換句話說,最難的題目上,旗艦依然保有明顯的優勢。
省錢的帳,看你轉哪一檔
官方的說法是,輸出速度比 Sonnet 5 快 30% 以上,多數工作每項任務成本最多低 30%。多項評測中,只開 Low 或 Medium 推理強度,就能超越 Sonnet 5 的最佳成績,每項任務成本約只有十分之一。
推理強度(effort):簡單說就是模型每次作答前願意花多少力氣思考,分 Low、Medium、High、Xhigh、Max 五檔。Claude App 預設 Medium,開發者 API 預設 High。
Artificial Analysis(AA)把它推到 Max。結果是智慧指數 56 分,全榜第二,僅次於 Opus 5.5(Max)的 58 分,比 Sonnet 5 的 38 分高 18 分,也領先 OpenAI GPT-6 Astra 3 分。AA 自測的 Terminal-Bench 裡,Sonnet 5.5 拿 64%,Opus 5.5 為 60%,領先的依然是 Sonnet。
代價是每項任務輸出約 19.3 萬 token,是 AA 測過最高的紀錄,比 Opus 5.5(Max)與 Sonnet 5(Max)多約 60%,約是 GPT-6 Astra 的 7 倍;每項任務成本 7.6 美元,比 Sonnet 5 高約 50%。
兩種說法並不矛盾。官方強調的是低、中檔位的效率,AA 量的是拉到最高檔的花費。單價便宜,但想得越久,帳單就越長。
對開發者來說,這代表選模型之外還得選檔位,而預設值本身就是定價策略的一部分:App 停在 Medium,API 則落在 High,兩者的帳單形狀並不相同。同一個模型,換一個預設值,開發者感受到的價格就可能差上一大截。
客戶的實測偏向前者。Box 副總裁 Yashodha Bhavnani 表示速度快 2.4 倍、總 token 用量少 12%;Zendesk AI 總監 Abhinay Kathuria 指出,客服工單的處理速度快了 20%;Lovable 技術長 Fabian Hedin 則提到,工具呼叫次數少了三分之一,shell 指令的執行次數約減半;Slack 首席工程師 Curtis Allen 也說,輸出 token 少了 14%。這些數字有個共通點:省的是多餘的來回,而不是單次推理的深度。
中階模型的門檻
Sonnet 5.5 是第一款搭載旗艦級資安防護的 Sonnet,防護程度與 Opus 5.5 類似。高風險的資安請求會自動退回 Sonnet 5 處理,原因是它的資安能力已與 Opus 5 相當;生物安全防護則維持與 Sonnet 5 相同。在 AA 的測試中,開啟官方預設的退回機制時,約 0.1% 的任務會退回 Sonnet 5。
另一項首度加入的設計,是阻擋「推理內容擷取」的安全分類器,並把模型保留的思考內容鎖在原始帳號上。白話說,就是防止別人大量套取模型的思考過程,拿去訓練自家模型,也就是未授權蒸餾。今年 2 月,Anthropic 曾指控 DeepSeek、Moonshot AI、MiniMax 透過約 2.4 萬個偽造帳號,對 Claude 發起超過 1,600 萬次查詢。
中階模型的用量遠大於旗艦,被大量呼叫,也就意味著被大量套取的風險更集中在這一級。當防蒸餾也得下放到 Sonnet,代表這一級的輸出,已經值得被偷,也值得被鎖上。能力逼近需要被管制的門檻時,防護就不再是旗艦專屬的配備。
Epic Games 營運長 Daniel Vogel 的評語很直接:品質已達一般會對更高階模型期待的門檻。

📍相關報導📍
偷接 Claude 被抓包?中國網信辦調查 DeepSeek、Moonshot,Anthropic 控敏感資料外洩
21 年解不開的德軍密電,GPT-6 Astra 花兩天成功破譯
Claude 是什麼?費用、功能、Claude Code、Cowork 完整解析 — 2026 Anthropic 最詳細指南


