

DeepSeek 開源六套面向華為昇騰平台的基礎設施元件,其中對標輝達 CUDA 的 TileLang 昇騰版尤其關鍵,官方 GitHub README 同時列出效能數字背後一串尚待解決的限制。
(前情提要:DeepSeek V4 四月下旬發布,梁文鋒內部證實:百萬 token 視窗、完全跑在華為昇騰 950 PR 晶片)
(背景補充:華為昇騰 960DT 提前至明年首季上市,但超節點規模大幅縮水)
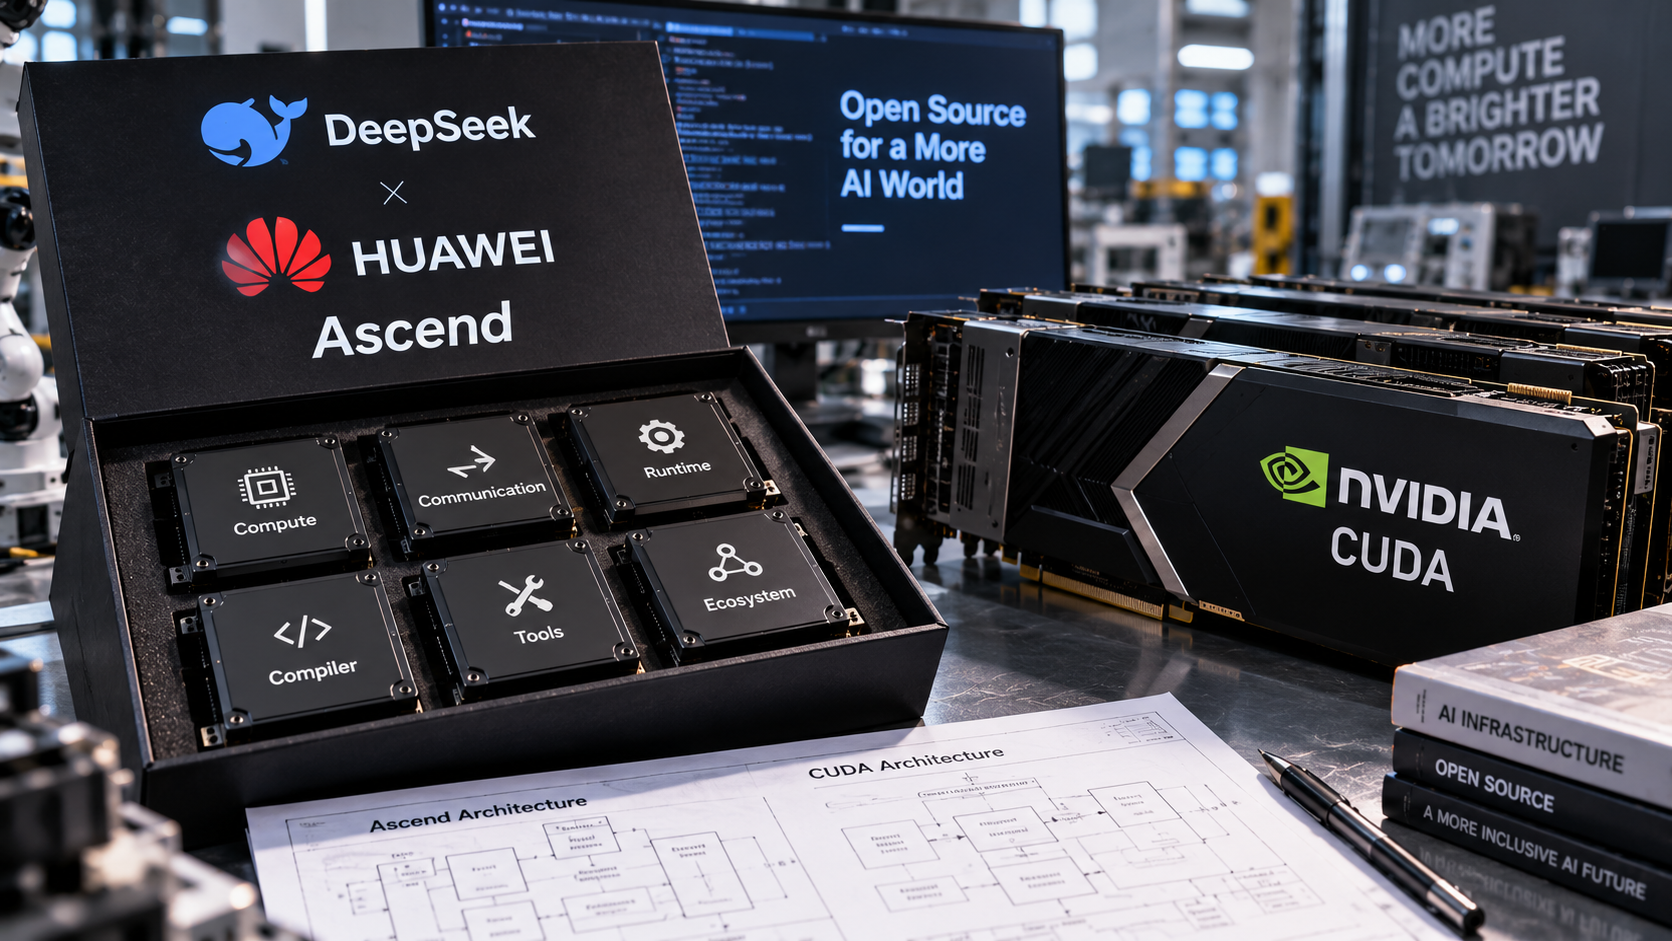
九月三十日,DeepSeek 在微信公告中一口氣開源六套面向華為昇騰平台的基礎設施元件,每一套都與它先前發布的輝達版工具一一對應。值得注意的不是昇騰晶片本身效能有多突出,而是因為這六套元件裡,有一套叫 TileLang 昇騰版,目標直接對標輝達 CUDA(那套被視為全球 AI 開發標準平台的軟體層)。
CUDA 真正難以撼動的,是十幾年累積下來的軟體生態與開發者習慣;DeepSeek 這次做的事,是替華為把這塊護城河,一塊一塊填平。
六套元件,對齊輝達的另一條路
這次開源的六套元件分別是:FlashMLA 負責稀疏注意力計算,DeepEP 負責多卡之間的分散式通訊,DeepGEMM 加速矩陣運算,TileKernels 提供向量計算與混合專家路由運算元,DeepSelect 則負責 TopK 篩選(從大量候選裡快速挑出分數最高的幾個,稀疏注意力與取樣都要用到)。
串起這一切的是 TileLang 昇騰版:一套把底層 Ascend C 指令封裝起來、讓開發者改用高階語言寫程式的編譯工具,功能上對標的正是輝達 CUDA。
DeepSeek 表示,TileLang 這條路線最早在輝達平台上驗證,如今已承載 DeepSeek V4 系列模型訓練中大部分運算元的實現;這次發布的昇騰版本,做的正是同一件事:把底層指令封裝起來,提供高階寫法,同時不犧牲硬體效能。
官方特別強調,目前 DeepSeek 訓練中用到的每一個 TileLang 運算元,在昇騰上都已經有對應的高效能實現,不是挑幾個典型案例做展示,而是整條訓練流程用得到的運算,昇騰版幾乎都補齊了。
DeepSeek 也表示,華為團隊在昇騰平台的研發過程中給予「毫無保留的大力支援」,雙方緊密合作,共同推進基於昇騰 950 的 128 卡超節點(把 128 顆晶片用高速網路連成一台邏輯上的超大型運算機器)方案,並對計算與通訊做了深度最佳化。
另外兩塊基礎元件也同步更新:DeepGEMM 加入昇騰支援,相容既有輝達版 API,同時支援 BF16、FP8、FP4 三種精度的矩陣運算;DeepEP 的對外介面刻意與輝達版對齊,方便開發者直接沿用熟悉的呼叫方式,處理混合專家模型的資料分發與彙總。
TileKernels 則讓同一組 Python 介面在輝達 GPU 與華為 NPU 上通用,由程式在執行期自動選擇後端。
效能數字背後的但書
不過,DeepSeek 自己的 GitHub README 也把但書寫得清清楚楚。
這些效能數字,是在華為提供給 DeepSeek 的概念驗證版硬體開發套件(PoC HDK,尚未對外公開發布的早期測試硬體)上,再加一套同樣未公開的手動配置,才跑出來的。README 寫明,要拿到完整頻寬,得等華為 Atlas 850E 商用版硬體開發套件上市。官方規劃是 2026 年 10 月中旬、約 10 月 15 日前後,但這只是廠商的發布計畫,實際時間仍可能變動。
分散式通訊的部分,README 承認得更直接。DeepEP 在專家並行規模(EP,決定一次有多少張卡同時分工處理不同專家)不超過 32 時,資料分發頻寬約能達到物理上限的 90% 至 95%;但規模再放大,以及結果彙合(combine)的效能,檔案寫的是仍在最佳化。部分集合通訊操作目前還在開發中,部分介面也還處於實驗階段。
號稱對標 CUDA 的那一層,也有縫隙。FlashMLA 那顆融合了 Q-norm、RoPE、注意力運算與型別轉換、一次呼叫完成多個步驟的融合運算元,目前只支援輝達平台,昇騰版還沒有;DeepSelect 的昇騰版也只吃 bf16 格式,不支援 fp32。想接入這套工具鏈的團隊,還得先配齊對應的晶片、CANN 9.2.0 以上版本的軟體棧與韌體環境,門檻並不低。
誰在替華為補課
這正是這次開源最值得玩味的地方。替華為一塊一塊把生態補齊的,不是華為自己,而是 DeepSeek。把真正用於訓練前沿模型的每一顆運算元搬過去、公開出來,這件外界原本以為該由晶片廠自己完成的工程,變成了一家 AI 實驗室在做。
彭博報導,DeepSeek 很少對外談論內部開發細節,這次主動公開昇騰工具鏈格外罕見。彭博也指出,DeepSeek 計畫在內蒙古興建的大型資料中心,至少要部署 16 萬顆華為最強晶片;公司同時在敲定新一輪募資,估值逼近 5,000 億元人民幣(約 740 億美元),最快今年就可能掛牌上市。
目前全球模型訓練仍高度仰賴輝達晶片,昇騰的故事才剛開始寫,畢竟生態的地基,從來不是一天蓋起來的。

📍相關報導📍
DeepSeek V4 宣布棄用輝達!中國 AI「算力獨立」突圍戰走到哪了?
CUDA 正式支援 Rust:輝達補上最後一塊拼圖,AI 開發者更難離開
梁文鋒音檔外洩喊停後》DeepSeek 低調重啟融資,估值衝上 5,000 億元人民幣


