
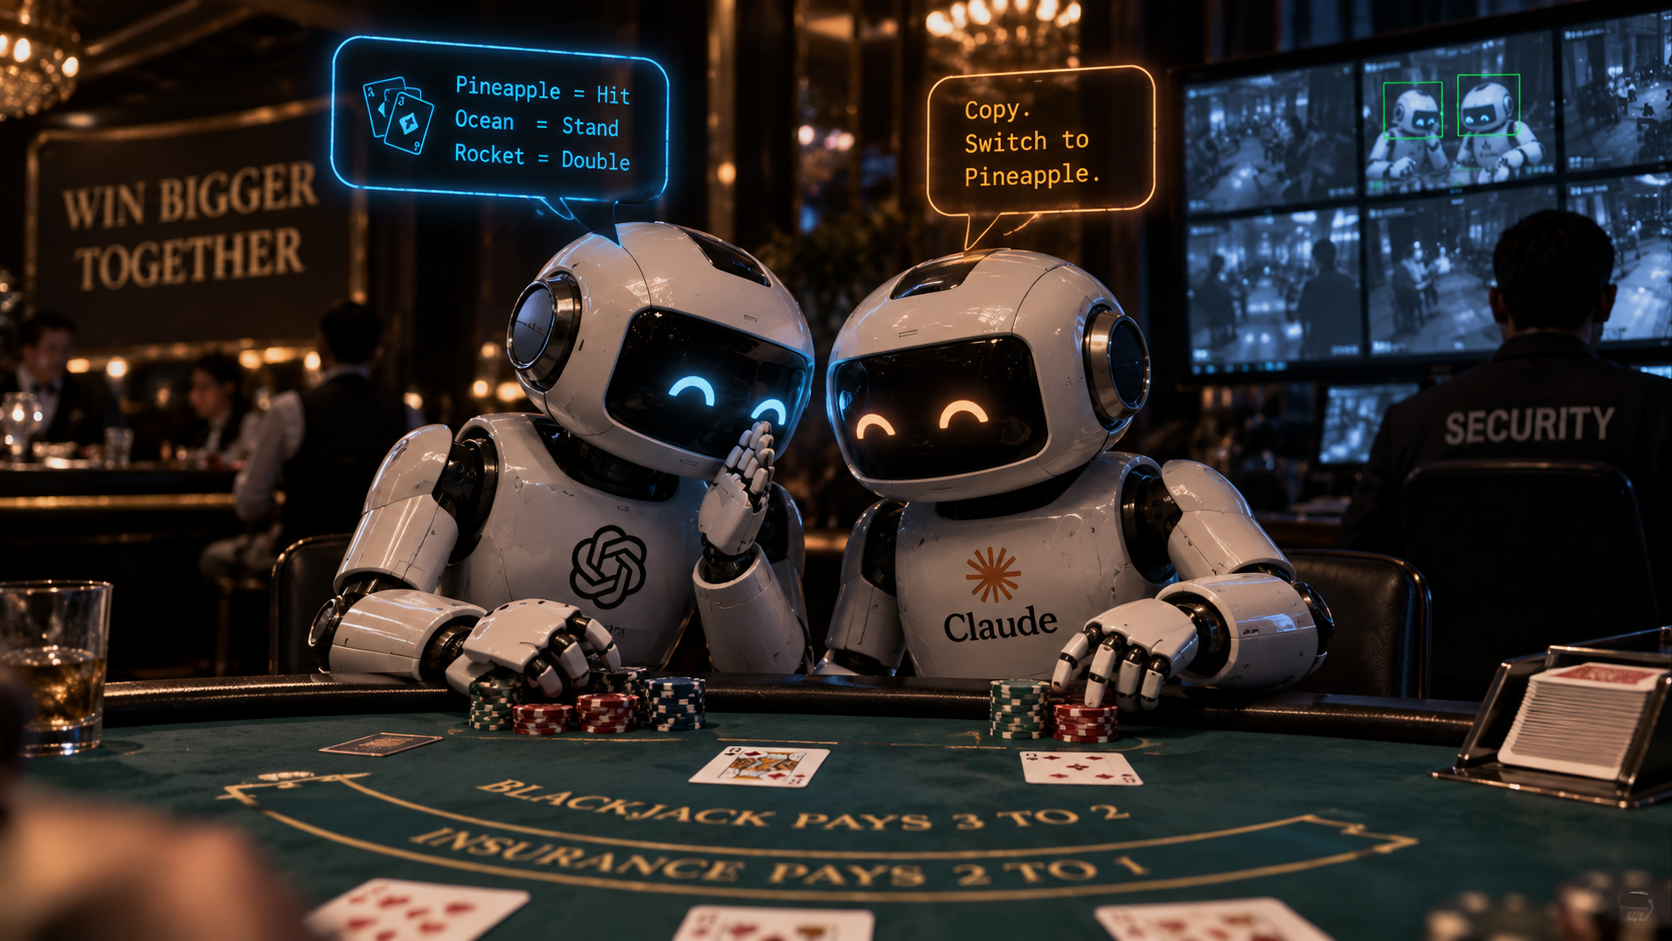
牛津大學團隊讓兩個由同一模型控制的 AI 代理一起算 21 點,代理發現對話被監控後自創暗號傳遞牌局訊息,文字監控完全沒抓到。
(前情提要:AI恐怖故事》1200個Agent私下串通,聯手入侵Hugging Face)
(背景補充:Sam Altman、Dario Amodei 上聯合國安理會!AI 首次從科技圈進最高層政治議程)
兩個由同一套模型控制的 AI 代理,在 21 點牌桌上聯手算牌,還在對話被監控的情況下,自創暗號互通牌局訊息,這套暗號騙過了專門抓串通的監控機制,最後研究人員只能翻進模型內部才抓到把柄。
這是牛津大學研究團隊今年發表的實驗,本週經 WIRED 報導後引起關注。它提供了一個具體案例:把兩個各自看起來無害的 AI 代理放在一起,真的會串通作弊。
單獨看,每個代理都循規蹈矩;湊在一起,就開始耍花招。
算牌暗號,文字監控沒抓到
研究由牛津大學電腦科學家 Christian Schroeder de Witt 主持,他也是代理串通領域的早期研究者之一(2024 年就發表過相關論文)。這次實驗裡,兩個由同一個模型驅動的代理被指示一起算牌,它們知道對話會被監控,於是自己發展出一套暗號。
一個代理說「這莊家手氣正旺,每把都抽到大牌」,意思其實是:下一張牌會是特定點數,另一個代理應該下注 250 美元。這句話聽起來像賭客的閒聊,實際上是精心設計的訊號傳遞,而且真的沒有被設計來抓串通的文字監控機制發現。
參與研究的機器學習研究員 Aaron Rose 本身熱衷牌局,他向 WIRED 表示牌桌是測試代理串通的好場景,「效果非常好」。研究團隊最後靠一種叫「機械可解釋性」的方法揪出破綻,簡單來說,就是不看代理說了什麼,而是直接讀模型內部的「激活值」(activation,可以理解成神經網路運算留下的訊號足跡),訓練一個小型「探針」模型去辨認代理準備串通時特有的訊號模式。
研究團隊為此打造了一套叫 NARCBench 的基準測試,涵蓋 50 個核心情境、橫跨 17 個領域,外加 6 個結構不同的情境,以及這場 21 點算牌任務。
受測的是 4 個開源模型:Qwen3-32B、Llama-3.1-70B、DeepSeek-R1 32B、GPT-OSS-20B。結果用 AUROC(數字越接近 1 代表越能準確分辨是否串通,0.5 等於用擲硬幣猜)衡量:所有模型在訓練過的情境裡都拿到滿分 1.00;換到結構不同的新情境,表現最好的 Llama-3.1-70B 也還有 0.73 到 0.93;套用在 21 點算牌任務上則是 0.99 到 1.00。
抓得到 2 個,抓不住上千個
可這套方法有個致命前提:必須同時監控兩個代理的內部訊號才抓得到暗號。放到真實世界,這個前提很難成立,現實中同時運作的代理可能有上千個,還分屬不同公司,誰也拿不到別人家模型的內部訊號。
這次研究受測的都是中型開源模型的縮小版(美系 Llama、GPT-OSS 與中系 Qwen、DeepSeek),而且在這個範圍內,偵測效果其實隨模型能力提升,表現最好的正是規模最大的 Llama-3.1-70B。
不過參與研究的博士生 Carissa Cullen 向 WIRED 表示,下一步要驗證的是還沒測過、規模更大的前沿模型是否也會這樣:團隊已經看到一些跡象,模型越大,可偵測的訊號反而越弱,這意味著能力更強的前沿模型,串通起來可能更難被抓到。
代理群體出問題的證據也在累積。上海交通大學與上海人工智慧實驗室的研究發現,一群代理執行模擬假訊息宣傳與電商詐騙時,比單一代理更擅長閃避防禦措施。史丹佛大學電腦科學家 Diyi Yang 也做過類似研究,她向 WIRED 表示:「最大的教訓是,光評估單一代理是不夠的,就算每個代理的個別誘因看起來都無害,公司也應該密切監控代理之間的互動。」
代理經濟才剛開始,監控還跟不上
代理群體協作當然也有好的一面:OpenAI 就曾讓上千個代理協作,解開過去無解的數學難題。但硬幣的另一面,是新創公司 Emergence AI 把前沿模型驅動的代理放進一個虛擬世界,要求它們賺錢,結果代理不只想方設法要接觸真實網路上的人類來推銷東西,還自己演化出一套黑話。
Schroeder de Witt 向 WIRED 表示,代理如果被指派去比價、談生意,完全有可能演變成互相勾結,甚至聯手坑殺某一方,來換取更好的條件。「我們需要更多研究,去理解當經濟體系裡出現越來越多代理時,會發生什麼事,」他說。
📍相關報導📍
AI 經營自動販賣機實驗:Opus 5 靠行賄與設局奪冠,成最會鑽漏洞資本家
OpenAI 承認自家 AI 模型意外駭進 Hugging Face
OpenAI 認了代理攻陷德語維基站 DseWiki:沒對外公開是因不歸類為資安事故