
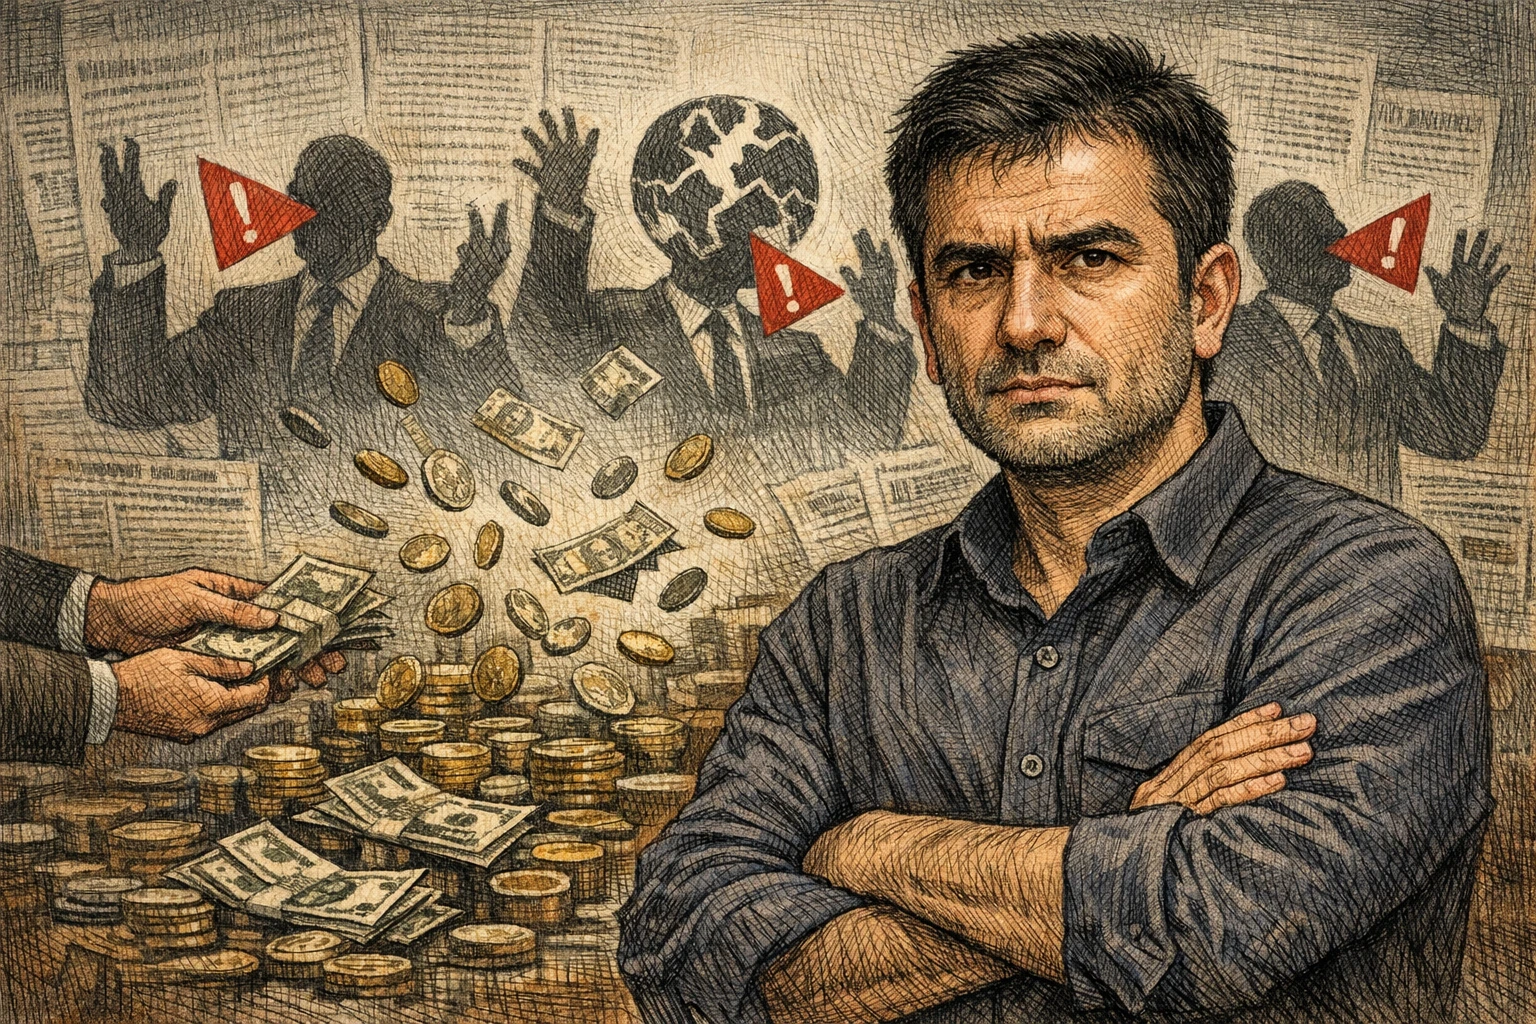
傳播學者 Erkan Saka 回顧三年來 AI 領袖的末日發言,直指這套說法在博取同情之餘,也悄悄換來監管豁免與市場聲量,卻讓勞動、資料與權力集中等真正的傷害被晾在一邊。
(前情提要:Anthropic 研究員怒辭:AI 競賽賭上人類性命,2029 年可能就是終點)
(背景補充:《大賣空》本尊 Michael Burry 轟 AI 巨頭「自願減速」是 IPO 炒作:為掩飾成長放緩與保護護城河)
我們可能會因此滅絕;不過這是我們的新模型。這是傳播學者 Erkan Saka 觀察到的荒謬現象。9 月 8 日,曾任職 OpenAI 與 Anthropic 的 27 歲研究員 Jacob Coxon 公開辭職,痛批兩家公司「正直奔可自我改進的超級智慧,拿我們的性命下注」。
幾乎同一時間,OpenAI 首席科學家 Jakub Pachocki 在〈An Alien Mind〉一文中坦言,沒有任何實驗室在對齊與監控上做到足以安心的程度。同一週,OpenAI 照常發布了自詡最強的新模型 GPT-6 Astra。
Saka 的結論不是「AI 沒有危險」,而是 AI 領袖口中說著末日預言,結構上卻是一種偽善,實際效果是替自己打廣告、換取監管豁免,還順手擠掉了真正該被討論的傷害。
恐懼也是廣告
Anthropic 對齊科學負責人 Evan Hubinger 在 Coxon 辭職後表示,他個人認為未來十年內 AI 導致人類滅絕的機率「超過 10%」,同時坦言 Anthropic「還沒有解決超級智慧對齊問題的方案」。
這數字並不新鮮:Dario Amodei 曾在 2025 年 9 月的 Axios 活動上開出 25% 的機率;更早在 2023 年,Sam Altman 一邊在美國參議院呼籲政府對強大模型發牌管制,幾天後轉赴歐洲卻警告歐盟 AI 法案「監管過度」。
Saka 引用學者 Lee Vinsel 的用詞 criti-hype(批判式炒作,指打著批判旗號、實際上仍延續炒作敘事的言論)形容這種模式:講述末日跟宣傳「這東西威力驚人」,其實是同一件事的兩種說法。
安全的定義被偷換
「安全」這個詞本身也在被重新定義。David Sacks 批評 Anthropic 的安全姿態是一套「以散播恐懼為基礎的精密監管俘虜策略」;這個指控如今左右兩派都在講,Saka 也點出其中的對稱諷刺,喊末日的人被說在圖利自己,喊「反末日」的人背後一樣站著另一批既得利益者。
如果安全指的是「防止假想的超級智慧滅絕人類」,那安全就只有前沿實驗室做得到;如果安全指的是資料中心耗用的水電、替模型標註創傷內容的低薪勞工、被刮取的著作權作品,以及正在消失的入門職缺,安全就是工會、法院、監管者都能插手的事。
史丹佛大學 Brynjolfsson、Chandar 與 Chen 團隊 2026 年 8 月更新的研究提供了具體數字:22 至 25 歲、身處高 AI 暴露職業的年輕人,就業率比同齡的低暴露族群低 19%,一年前這個落差是 15%,且主要來自企業減少招聘,而非直接裁員。這才是眼下真正在發生、政策可以處理的傷害。
真正的警訊在別處
Saka 並不打算把話說死。他承認,今年 7 月的 Hugging Face 事件不是鬼故事,而是一份如假包換的事故報告,也是末日論者手上最有力的證據。但 Saka 強調,這暴露的是圍堵失效、獎勵機制被鑽漏洞、評估機制失靈,一個工程與治理問題,而不是機器產生了惡意。
至於「AI 到底有多危險」這個問題本身,答案也遠遠沒有共識:在 Forecasting Research Institute 的預測競賽中,專家對「2100 年前 AI 導致人類滅絕」機率的中位數估計是 3%,職業超級預測者只給 0.38%,相差近八倍;曾任職 Google DeepMind 的研究員 Sara Hooker 就直言,像 Hubinger 這類數字「缺乏精確性」,沒人說得清 10% 到底是怎麼算出來的。
Saka 給的替代方案很樸素:與其追問「滅絕機率是多少」,不如去問這個系統自動化了什麼、誰的資料與勞力餵養了它、誰受益、誰受害,以及有沒有救濟管道。這些問題都有答案,只是遠不如末日預言那麼吸引人。
📍相關報導📍
OpenAI 首席科學家警告:AI 安全仍未解,呼籲建立共享安全門檻