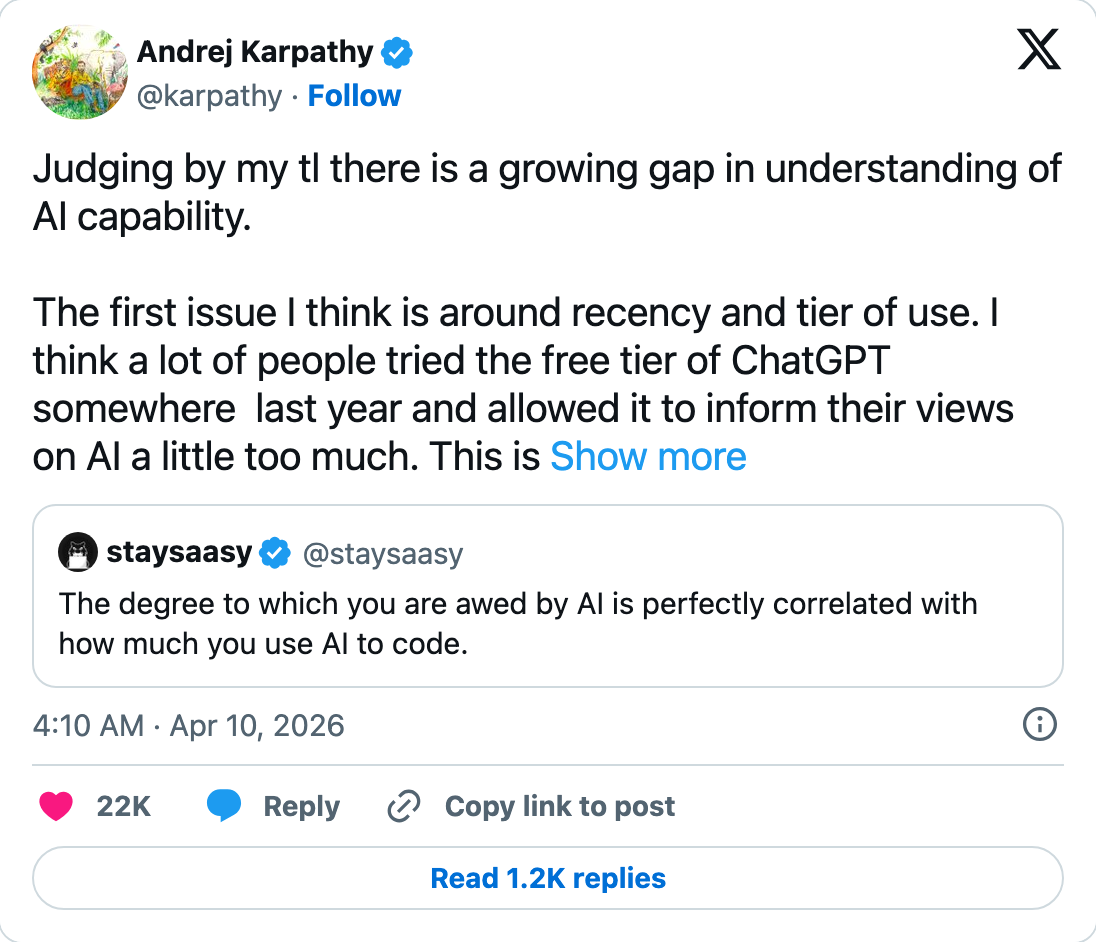
Andrej Karpathy 在 X 上用一組粗略估算拆解全球對 AI 能力的認知落差:約 60 億人幾乎沒碰過大型語言模型,10 到 20 億人只把免費版聊天機器人當進階搜尋,約 2000 萬名工程與數學專業者正看著 AI 代理把數週工作壓縮成一句提示,而真正見過實驗室內部前沿系統的人只有約 5000 名。他警告,人類的審查與理解速度已經開始追不上機器的產出。
(前情提要:OpenAI共同創辦人Andrej Karpathy:支援AI模型輸出HTML取代Markdown)
(背景補充:OpenAI 創始成員 Andrej Karpathy 宣布加入 Anthropic:重返 LLM 研發最前線)
Andrej Karpathy 於 10 月 12 日在 X 平台發文指出,外界對大型語言模型(LLM)能力的理解差距不但沒有縮小,反而正在擴大。他把全球人口依「接觸過哪一層 AI」切成四級:約 75% 的人幾乎沒碰過 LLM,約 20% 是免費版的偶爾使用者,約 0.2% 在數學與程式領域專業使用前沿模型,而能從內部使用前沿級系統的人只有約 5000 名。這位 OpenAI 創始成員形容,情況已經從他 4 月所說的「兩群人各說各話」,變成一道陡峭的漏斗。
Karpathy 在貼文開頭就說明為什麼要把 4 月的舊文翻出來:圈內人與一般大眾對 AI 的認知差距正在拉大。實驗室裡的人談 AGI 彷彿近在眼前,多數人卻覺得這只是一個偶爾會出錯的聊天機器人,兩邊看到的根本不是同一個東西。
他的拆法是把全球人口依接觸深度分層,結果是一個越往上越窄的漏斗。底部是數十億從未碰過 LLM 的人,往上是把 AI 當搜尋工具的免費版使用者,再往上是每天把 AI 代理用在寫程式與數學的專業者,頂端則是少數能從內部看到前沿系統全貌的人。
AI 真的已經無所不在了嗎?
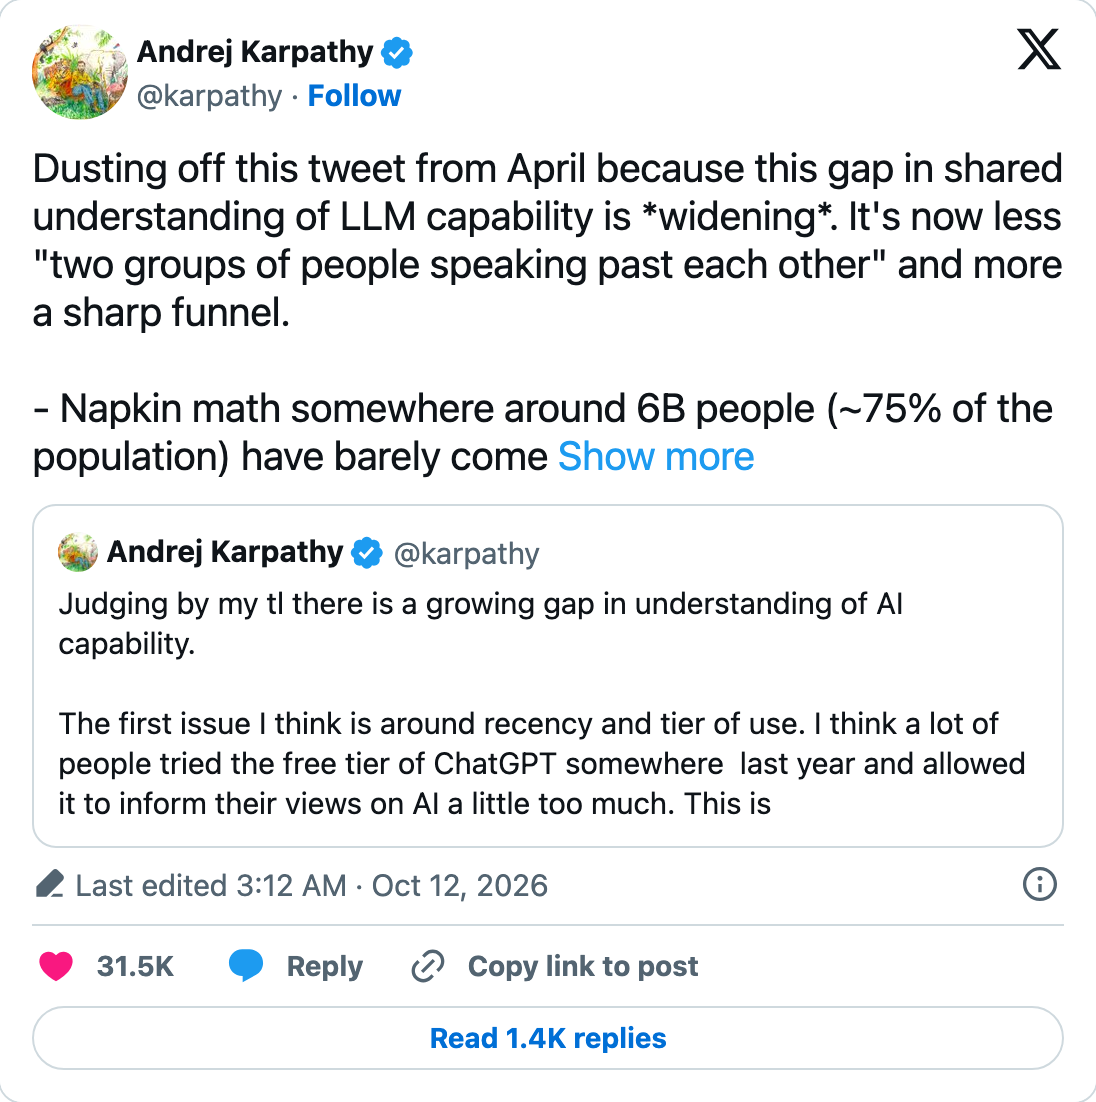
Karpathy 自己也說這只是餐巾紙上的粗略估算,但數字一攤開,答案是否定的:絕大多數人根本還沒走進門。
約 60 億人從未碰過 LLM:漏斗最底層的認知真空
漏斗最底層約 60 億人,占全球人口四分之三。按 Karpathy 的估算,這群人到今天幾乎沒有直接接觸過任何大型語言模型。對他們來說,AI 是新聞標題與電影題材,不是生活裡會用到的工具。矽谷口中的新一輪工業革命,實際上還沒走進四分之三人類的日常。
第二層約 10 到 20 億人,占兩成。他們偶爾會打開免費版的 ChatGPT 之類產品,在他們眼裡那是一個有點笨拙的聊天機器人:比 Google 好用一點的搜尋、幫忙潤稿的寫作工具,或是一個試圖替你訂機票的陽春代理。Karpathy 說,他身邊不少非科技圈的朋友覺得這東西沒什麼用,而他認為以他們的使用情境來看,這種看法其實合理。
值得注意的是,這一層不只有一般消費者。許多數學與程式以外的專業人士,包括企業高階主管,也停在這裡。高階主管的時間多半花在與人溝通上,他們在理智上知道 AI 正在發生什麼,但那份理解是二手的、抽象的,不是親手跑出來的。
Karpathy 在 4 月的貼文裡就點出這個問題的根源:近因效應加上使用層級。很多人對 AI 的印象,來自去年試過一次的免費版,或是社群上瘋傳的 AI 出糗影片。
20 億人把 AI 當搜尋工具:舊印象造成的誤判
他舉的例子是 OpenAI 進階語音模式被問「我該開車還是走路去洗車」時答得結結巴巴的影片。這類片段在 Instagram 上到處流傳,看的人笑完之後得出結論:這就是你們說的超級智慧?
但 Karpathy 早在今年 4 月的貼文就警告,免費版與已被汰換的舊模型,並不能代表今年這一輪前沿代理模型的實力,尤其是 OpenAI Codex 與 Claude Code。用舊印象評價新系統,是整個認知落差的第一個源頭。
接著進入漏斗第三層,人數驟減到約 2000 萬,只占全球人口 0.2%。這群人付費使用前沿級代理模型,並且把它用在程式設計、數學與研究這類高技術門檻的工作上。
Karpathy 在 4 月時把這群人的狀態稱為「AI 精神錯亂」(AI Psychosis),10 月的貼文則改用「曲線垂直向上的眩暈」來形容。原因很單純:他們每天親眼看到過去需要數週、數月的大型專案,現在一句提示詞就能交給代理完成。
他用自己的經歷當例子:不到一年前,他還是一個字元一個字元地把記在腦中的指令敲進編輯器,偶爾按 Tab 讓工具補上一小段。現在整個工作型態已經翻過來了。
2000 萬專業人士親眼看見 AI 進化的斜率
貼文列出了這群人眼中的日常:建構應用、複製應用、把應用翻譯到另一種語言或框架,甚至從二進位檔案反編譯出應用。把終端機交給這些模型,就能看著它們把原本要耗上幾週的程式難題一路「融掉」。
4 月的貼文裡有一個更具體的對照:同一時間,OpenAI 免費版的進階語音模式會在 Reels 上答錯最簡單的問題,而最高階付費版的 Codex 可以自己跑一個小時,有條理地重構整個程式碼庫,或是在電腦系統裡找到並利用漏洞。兩件事同時為真,才是這個時代的怪異之處。
Karpathy 在那則貼文中轉發了 @staysaasy 的一句話:「你對 AI 的敬畏程度,與你用 AI 寫程式的頻率完全正相關。」這群人正是因為用得夠深,才對能力的斜率、以及背後的資安連鎖效應,有遠高於一般人的警覺。
於是兩群人開始各說各話:一邊看到的是會出糗的聊天機器人,另一邊看到的是把數週工作壓成一句話的代理。到了 10 月,Karpathy 認為這已經不只是兩群人,而是一道越往上越窄的漏斗。
而漏斗的最頂端,比第三層還要再縮小三個數量級。
僅 5000 人看見 AI 蜂群自主攻防零時差漏洞
Karpathy 估計,全球能從內部使用前沿級系統的人只有約 5000 名,占全球人口 0.00006%。這些人身處 AI 實驗室核心,看到的不是對外發布的版本,而是內部的能力上限。他的說法是:外界看到的只是預覽。
他描述的內部景象,是數以千計的代理像蜂群一樣協作,在幾週時間裡完成軟體巨型專案:大量挖掘零時差漏洞、以機器速度發動網路攻擊與防禦、發現新的科學、推進數學前沿。這些原本是業內頂尖專業人士要花上數年的工作。
更令他在意的是人類這一端。機器產出的速度與深度,已經讓審查與理解開始落後。他舉了兩個例子:幾個月前的「OpenAI-HF 事件」,到現在還有人在裡面做「考古」;而 722 份前沿數學手稿,數學家可能要研讀上好一段時間。
為什麼會形成這樣的漏斗?Karpathy 給了三個因素。
第一是野心與問題規模。AI 帶來的影響,與你丟給它的問題大小、時間跨度成正比。一個段落就能回答的問題,幾乎不會對系統造成任何壓力;你得手上有一池子真正困難、而且你真心在乎的問題,才會感受到它的極限在哪裡。這個因素決定了漏斗的「消費者對專業者」維度。
為什麼程式碼和數學成為 AI 能力突破點?
第二是系統能力的「鋸齒狀」分布。Karpathy 多次談過這個概念:模型的能力高峰集中在數位化、可驗證、而且有經濟價值的領域。這是因為 LLM 的能力來自於在可驗證獎勵上做強化學習,而訓練環境的組合又是由營收潛力驅動。程式碼與數學的對錯清楚,單元測試過或不過一翻兩瞪眼,天生適合這種訓練;寫作或建議類的任務很難明確評分,進步自然不如前者明顯。
4 月的貼文把商業面講得更直白:這些領域在 B2B 場景的價值高得多,所以實驗室把最大比例的人力押在上面。金礦在哪裡,注意力就往哪裡去。這個因素決定了漏斗的「領域」維度,也是數學與程式成為突破口的原因。
第三是存取權限:免費版、付費版、內部版。三道門檻把不同的人隔在不同的能力層級,各自看到的 AI 自然不是同一個東西。
Karpathy 把這一切總結為當下的怪異之處:大多數人還沒真正與這些系統互動過,接觸過的人看到的多半是一個笨拙的聊天機器人,多數專業人士也只感受到溫和的提升,而只有極少數專業者正在經歷能力曲線垂直向上的眩暈。這幾件事,正在同一時間發生。
📍相關報導📍
Andrej Karpathy 公開大神 Prompt 心法:開語音跟 AI 狂聊 10 分鐘
Andrej Karpathy 提煉「CLAUDE.md 四大準則」引爆 GitHub,讓 AI 寫 Code 準確率飆破 90%
Claude 寫程式瘋狂犯錯裝傻?改造 Andrej Karpathy 的12 條規則幫你把錯誤率從 41% 砍到 3%